Bei meinen Mandaten läuft die Entwicklung seit Jahren nach demselben Muster. Je Work Item in Azure DevOps gibt es eine eigene unmanaged Solution, Unique Name feature_4711 oder bug_4712. Darin landet alles, was zu dem Thema gehört. Ist das Thema fertig, wandert der Inhalt in die Release-Solution, und die geht als managed Paket durch die Umgebungskette. Das ist das Nächste an Feature-Branches, was Dataverse hergibt, und es funktioniert.
Was nicht funktioniert, ist alles drumherum.
Vierzig Solutions und eine Excel-Liste
Nach drei Monaten stehen im Maker-Portal vierzig Solutions mit Namen wie feature_4711, und niemand weiß mehr ohne DevOps, was 4711 war, ob es schon im Release ist und wem es gehört. Zwei Kollegen ändern dasselbe Formular in zwei Solutions, und wer zuletzt deployt, überschreibt den anderen. Davon merkt man erst etwas, wenn in UAT ein Feld fehlt.
Und der Merge selbst. Im Maker-Portal in der Release-Solution auf „Add existing", dann Typ für Typ, Komponente für Komponente, bei jeder Tabelle die Frage, ob alle Unterkomponenten mit sollen. Bei dreißig Komponenten eine halbe Stunde, bei dreihundert ein Nachmittag. Danach kann niemand sagen, was genau hinzugekommen ist, und die Release Notes schreibt man aus dem Gedächtnis.
Ich habe das jahrelang mit einer Excel-Liste gelöst, in der die Solutions den Work Items zugeordnet waren, und mit der XrmToolBox. Der Solution Components Mover dort verschiebt Komponenten zwischen Solutions, ganz brauchbar. Aber er weiß nichts von Work Items, Zuständen oder davon, was schon gemerged ist. Und die Liste pflegte sich nicht selbst. Nach zwei Releases stimmte sie nicht mehr, und ab dann war sie schlimmer als keine, weil man ihr noch glaubte.
Nach zwei Releases stimmte die Liste nicht mehr, und ab dann war sie schlimmer als keine, weil man ihr noch glaubte.
Eine Working Solution ist zwei Dinge
Am 10. Juni 2026 habe ich den ersten Commit gemacht. Die App hieß damals Solution Forge, der Name hielt einen Tag. Die Kernidee hat sich seitdem nicht geändert: Eine Working Solution besteht aus einem Datensatz mit Titel, Typ, DevOps-ID, Owner und Deployment-Status, und aus der echten unmanaged Solution, die die Komponenten trägt. Beim Anlegen entsteht beides in einem Schritt, der Unique Name folgt weiter der Konvention. Solutions, die jemand am Werkzeug vorbei angelegt hat, bleiben sichtbar und werden über den Namen eingeordnet.
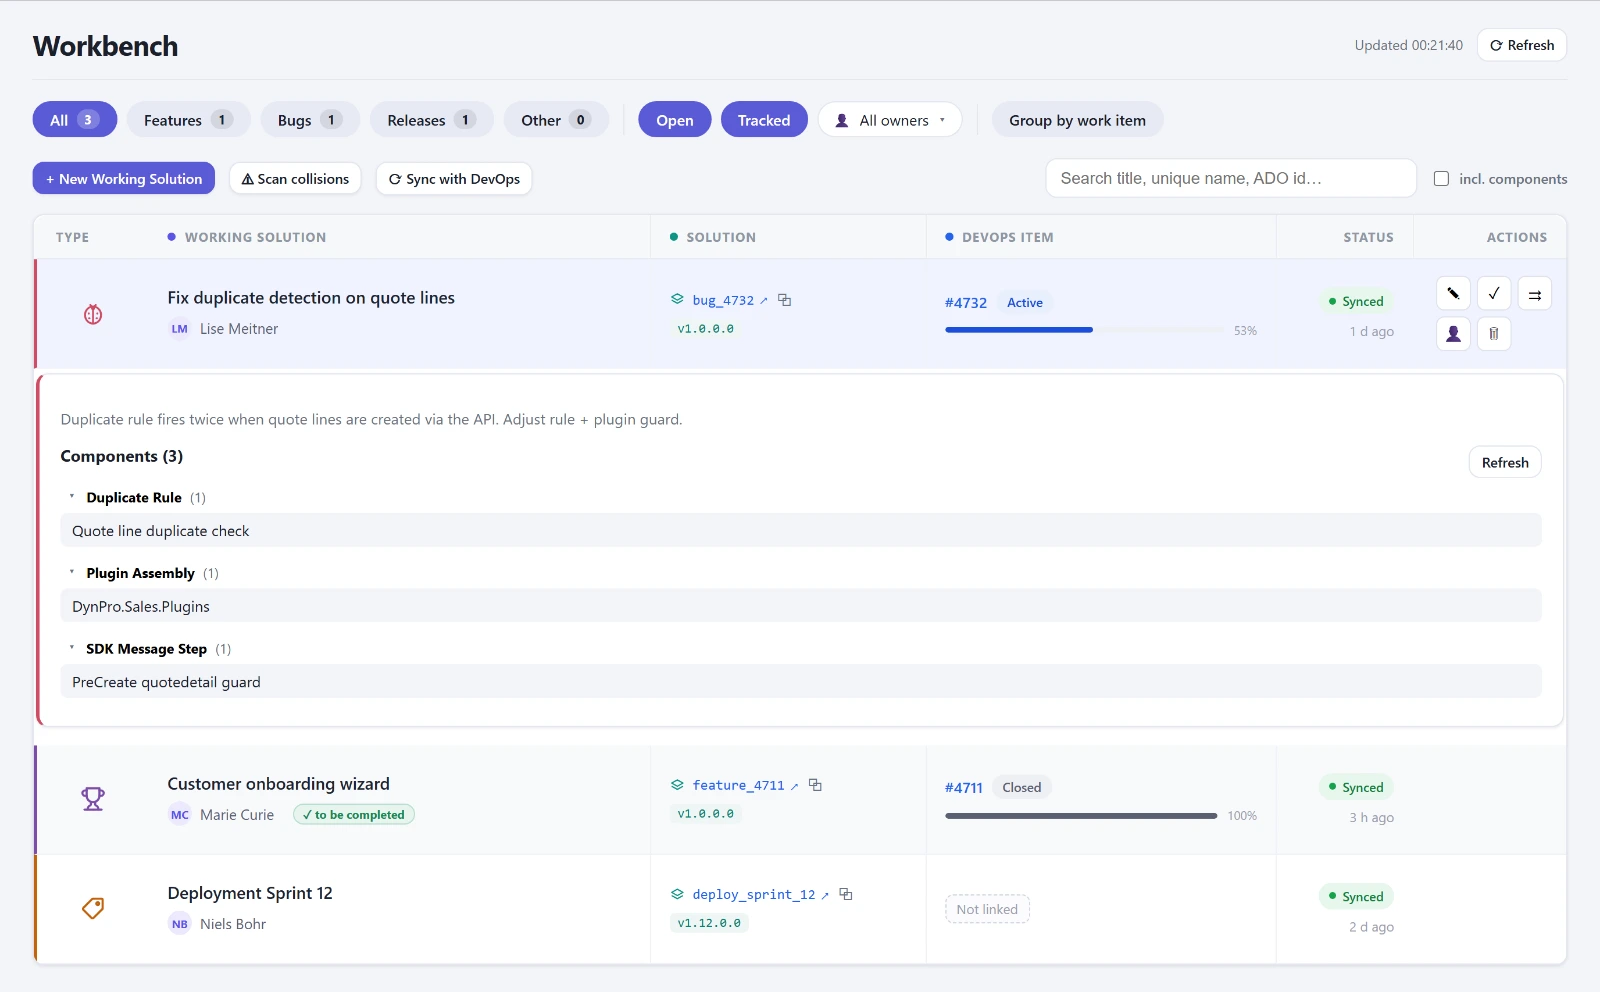
Damit war die Excel-Liste weg. Die Workbench zeigt die Liste mit Filter nach Feature, Bug und Release, mit Suche über Titel, Unique Name und DevOps-ID. Ein Schalter durchsucht zusätzlich die Komponenten aller offenen Solutions, und damit ist die Frage beantwortet, die mir im Projekt am häufigsten gestellt wurde: In welcher Solution steckt diese Tabelle? Das Kollisions-Radar kam am zweiten Tag dazu. Es lädt die Komponenten aller offenen Solutions und markiert jede, die in mehr als einer steckt. Genau dort überschreibt später jemand jemanden.
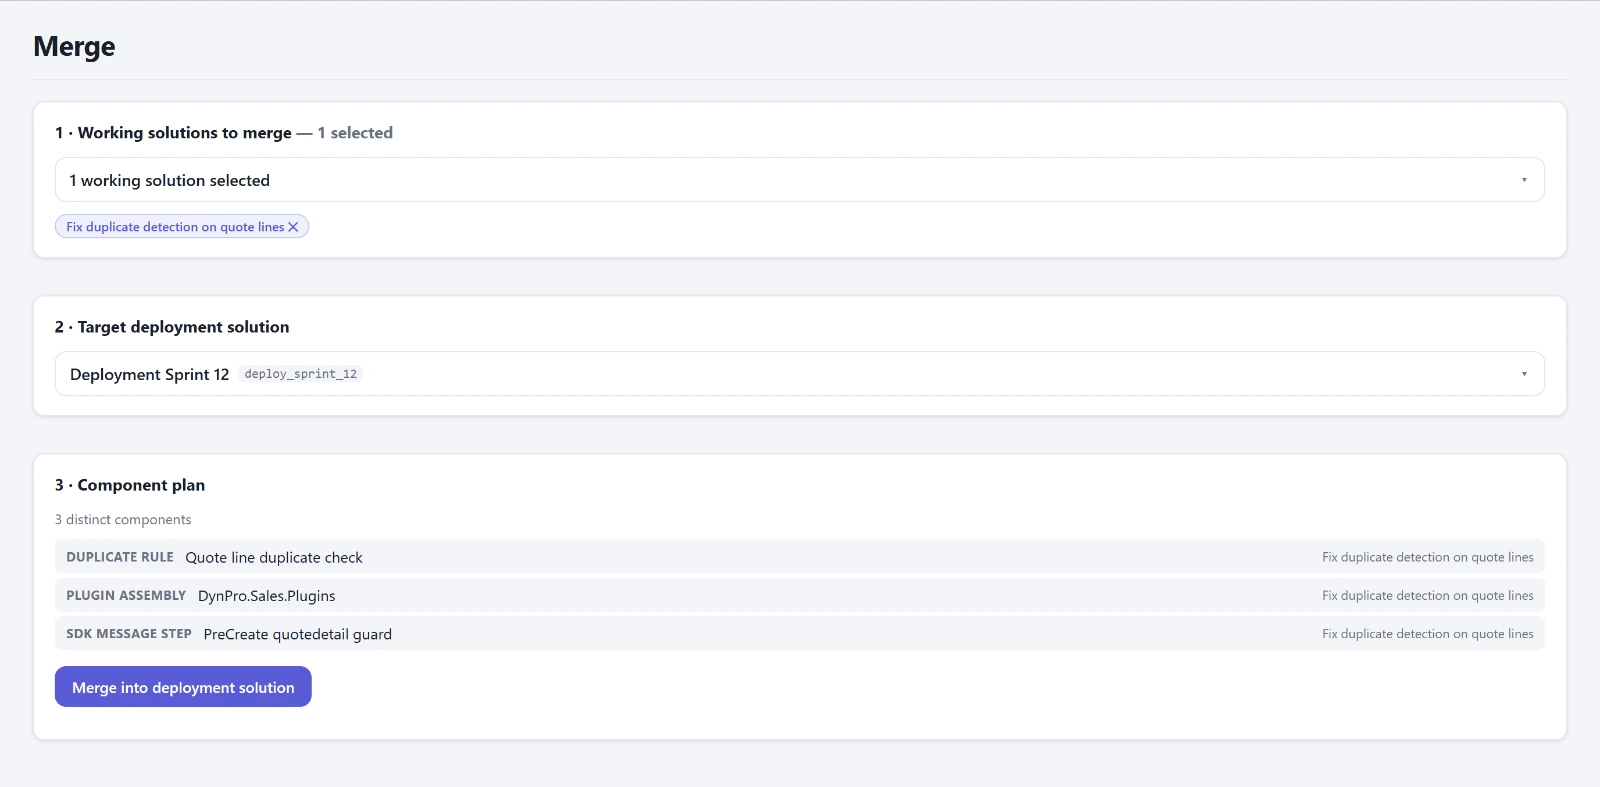
Der Merge wählt eine Release-Solution als Ziel, dann die Feature- und Bug-Solutions, zeigt den Komponentenplan mit Konflikten und Duplikaten, und führt zusammen. Jeder Lauf schreibt eine Historienzeile mit den hinzugefügten Komponenten. Aus dieser Historie entstehen seit dem 22. Juni die Release Notes, ab dem zweiten Mal inkrementell. Das war kein geplantes Feature. Die Daten lagen einfach da.
Dazu kam ein Cloud Flow, der den Status der Work Items zurück in die Working Solutions schreibt. Steht ein Work Item auf Done, die Solution ist aber noch offen, markiert die Liste das. Mehr Integration mit DevOps hatte ich geplant, ein Panel war schon gebaut. Es scheiterte am Tenant: Das OAuth-Token kam aus dem Heimat-Tenant meines Kontos, die DevOps-Organisation hing an einem anderen, Fehler TF400813, eine Gastmitgliedschaft hilft da nicht. Das Panel ist seit dem 11. Juni abgeschaltet und wartet auf einen Service Principal.
Was es gebracht hat
Der Merge dauert Minuten statt einen Nachmittag, und danach steht fest, was hinzugekommen ist. Die Release Notes fallen ab. Kollisionen sieht man, bevor jemand deployt. Die Konsole läuft seit zwei Wochen bei einem Kunden aus der Automatisierungstechnik im Alltag, mit drei Umgebungen und einem Team, das vorher die Excel-Liste geführt hat.
Was die Workbench nicht beantwortet: ob der Import im Ziel durchgeht. Darum geht es im zweiten Teil. Alle Funktionen der Workbench stehen auf der Produktseite.
Nachtrag vom 2. August: der Fehler, den man nicht sieht
Der Merge lief zwei Monate im Alltag, und er hatte einen Fehler, den man nicht sieht. Die Komponentenliste kam aus derselben Tabelle, die auch das Maker-Portal für seine Objektliste nutzt. Diese Tabelle klappt Unterkomponenten unter ihrer Tabelle zusammen. Ein Merge darüber kopierte bei einer Tabelle also nur die Hülle und ließ die Spalten, Formulare und Ansichten zurück, die in der Quelle explizit drin waren. Keine Fehlermeldung. Die Komponente war ja im Ziel.
Noch schlimmer war die Dublettenprüfung. Führte das Ziel die Tabelle bereits als Hülle und die Quelle sie mit allen Unterkomponenten, dann übersprang der Merge sie als Duplikat. Am 1. August habe ich das live an einer Tabelle gesehen, deren Spalten im Release fehlten. Seit dem 2. August entscheidet eine reine Funktion mit Tests, was mit jeder Komponente passiert: hinzufügen, aufweiten, überspringen oder ausgeschlossen. Aufweiten heißt, die vorhandene Zeile wird an Ort und Stelle auf „alle Unterkomponenten" hochgestuft. Dataverse stuft dabei nie zurück, ein wiederholter Aufruf ist also risikofrei.
Eine Nebenwirkung, die mich kurz hat zweifeln lassen: Nach dem Aufweiten sinkt die Zeilenzahl der Ziel-Solution. Aus drei Zeilen, Hülle plus zwei explizite Spalten, wird eine Zeile mit allem. Weniger Zeilen, mehr Inhalt. Wer Komponentenzahlen als Erfolgsmaß nimmt, liest daraus einen Verlust.
Nachtrag vom 16. September: null Prozent
Der Merge stand bei großen Releases minutenlang auf null Prozent, weil er vor dem ersten Schritt die Release-Solution komplett auflöste, mit Namen für jede Spalte, jedes Formular, jede Ansicht. Davon wurde nichts angezeigt. Die Entscheidung braucht nur die ID und das Verhalten der Zeile. Jetzt liest er das Ziel roh, nimmt die Quellen aus dem Plan der Workbench mit, und der Fortschritt läuft ab der ersten Sekunde. Die Aufrufe selbst laufen weiter nacheinander. Parallel ginge vermutlich, aber nicht ohne vorher zu prüfen, wie Dataverse die Ziel-Solution sperrt.